
KI i forskning: Svarene som gjemmer seg i full offentlighet

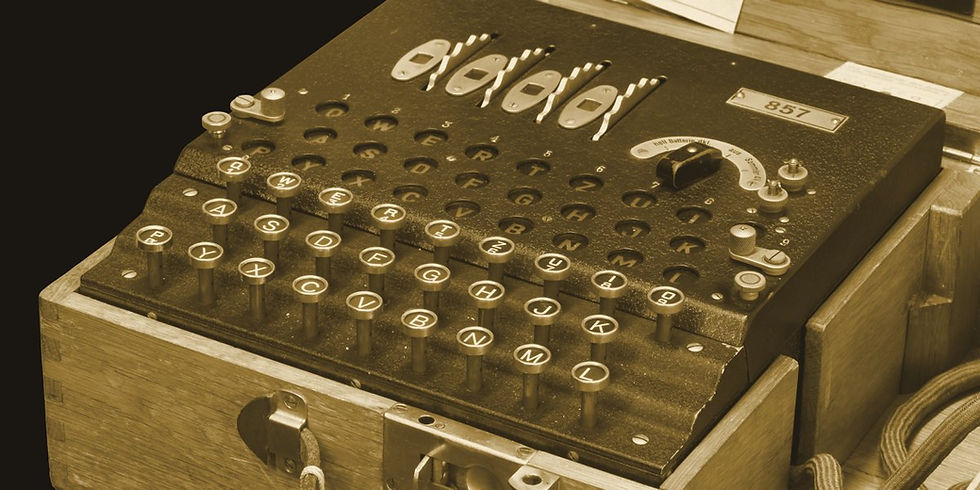
Image: "Enigma-IMG 0487-black" by Rama (CC BY-SA 2.0 fr) via Wikimedia Commons, recoloured.
Velkommen til ukens oversikt over hvordan KI endrer forskningen, kuratert fra Nature, Science, PNAS og de ledende økonomisk-administrative tidsskriftene.
KI finner svarene som gjemmer seg i full offentlighet. Hvem kontrollerer dem?
To saker denne uken beskriver det samme skiftet fra hver sin kant. Science omtaler BootLoops, programvare som lot forskere raskt finne og angripe problemer innen 22 fagdisipliner. Verktøysettet vokste frem under Harvard-fysikeren Matthew Schwartz' opphold som gjesteforsker hos Anthropic, der Claude bygde verktøy problem for problem. Ifølge omtale av prosjektet ble omtrent 400 kandidatproblemer snevret inn til 36 manuskripter med 19 medforfattere i løpet av tre måneder, om temaer fra stjernerangeringer i Medicare til solflekker, ofte ved å overføre en kjent metode fra ett felt til et annet der ingen hadde tenkt på å bruke den. Samtidig melder Nature at ikke-eksperter bruker store språkmodeller til å knekke historiske chiffer: én person, uten bakgrunn i kryptografi, lot en modell velge ut en uløst Enigma-melding fra 1941, skrive en Enigma-simulator og teste mer enn fire milliarder innstillinger i løpet av natten til en løsning dukket opp.
Haken er den samme i begge tilfellene. Schwartz opplevde det som vanskelig å vurdere når modellen overdrev funnene i ukjente felt, så fageksperter avgjorde hvilke resultater som var verdt å forfølge; mange tidlige resultater var teknisk korrekte, men vitenskapelig lite bemerkelsesverdige. Og kryptografer fortalte Nature at innboksene deres oversvømmes av forespørsler om å validere KI-produserte løsninger, mange av dem falske positive fra folk som ikke forstår kryptoanalyse. En konseptuell artikkel i Strategic Entrepreneurship Journal av Haiyang Zhang, Robert Wuebker og Jay Barney gir dette et strategisk perspektiv: muligheter som hviler på konkurransemessig forsømmelse, kan miste verdien sin når generativ KI gjør skjulte renter synlige for alle, mens muligheter skapt under genuin knightiansk usikkerhet er slike som generativ KI ikke fullt ut kan løse.
Hvorfor det betyr noe: For forskere er «lavthengende frukt ingen la merke til» i ferd med å bli en krympende ressurs; KI er svært god til å overføre eksisterende metoder til forsømte kroker. Det som forblir knapt, er dømmekraft: å vite hvilket resultat som betyr noe, og å kunne verifisere det. Hvis du bruker KI til å speide etter forskningsproblemer, bør du sette av ressurser til ekspertvalidering på forhånd, rapportere hvordan kandidatene ble filtrert (fra 400 til 36 er i seg selv et funn), og regne med at fagfeller og redaktører vil møte den samme valideringsflommen som kryptografene allerede gjør.
Mer fra denne uken
KI-lagde annonser fungerer best når de ikke ser KI-lagde ut
I samarbeid med Taboola i forkant av lanseringen av selskapets GenAI Ad Maker sammenlignet forfatterne 4 633 «søskenannonser»: KI-genererte og menneskeskapte bilder lansert av de samme annonsørene, med identiske kampanjeinnstillinger og på samme tidspunkt, til sammen over 369 millioner visninger og 2,5 millioner klikk. De fant ingen påviselig gjennomsnittlig ulempe i klikkrate for KI-bilder, men KI-bilder gjorde det bedre enn menneskeskapte når de ikke «så KI-lagde ut». Interessant nok ble trekk som KI har en tendens til å produsere (skarpere, klarere bilder med større ansikter) tolket av forbrukerne som menneskeskapte, mens tung estetikk, lavere varme og intens fargemetning signaliserte KI.
Et KI-«legepanel» testet på sekvensiell diagnostikk
Denne artikkelen i Science bygger en interaktiv referansetest der diagnostikeren starter fra en kort sykdomspresentasjon og må velge hvilken informasjon og hvilke prøver som skal innhentes, slik at både treffsikkerhet og utredningskostnad kan måles. Et KI-system som simulerer et panel av leger, og som fortløpende reviderer differensialdiagnosene sine og velger kostnadseffektive prøver, oppnådde 83,2 % treffsikkerhet på klinisk-patologiske kasus fra New England Journal of Medicine og 80,3 % på akuttinnleggelser fra MIMIC-IV, mot 36,1 % og 46,8 % for allmennleger. Forfatterne understreker at dette er resultater fra kontrollerte referansetester, men selve designet (å vurdere prosessen og ikke bare svaret) er en nyttig mal for å evaluere KI i enhver sekvensiell beslutningsoppgave.
Hvordan KI endrer venturekapital, oppgave for oppgave
Denne konseptuelle artikkelen utvikler en mekanismebasert forklaring på hvordan data og KI omformer venturekapital, en bransje bygd på geografisk og sosial nærhet. Den fremsetter proposisjoner om tilgang på investeringsmuligheter (KI kan utvide trakten utover lokale nettverk og personlige introduksjoner), utvelgelse (raskere og mer konsistent due diligence, men modeller trent på tidligere avtaler kan favorisere selskaper som ligner på tidligere investeringer og overse nyskapende selskaper) og arbeid etter investering, der data delvis kan erstatte overvåking, mens verdiskapende støtte fortsatt er relasjonsintensiv. Et ferdig sett med testbare hypoteser for forskere innen entreprenørskap og finans.
Mer pålitelig styring av store språkmodeller innenfra
Aktiveringsstyring (direkte manipulering av en modells interne aktiveringer for å dytte utdataene mot et bestemt konsept) er notorisk skjør. Forfatterne foreslår et oppmerksomhetsstyrt rammeverk som automatisk velger relevante tokens, håndterer heterogene konsepttrekk og identifiserer de lagene som betyr mest. På en referansetest med 512 semantiske konsepter nesten doblet det antallet konsepter som ble styrt med hell sammenlignet med tidligere beste metode, på tvers av arkitekturer med opptil 70 milliarder parametere. For forskere som bruker store språkmodeller som instrumenter, er dette en påminnelse om at modellatferd kan forskyves innenfra, og ikke bare via instrukser.
Debatten om KI-sikkerhet mangler halve systemet
Denne kommentaren i Science svarer på KI-lederes nylige advarsler til FNs sikkerhetsråd og hevder at foreslåtte sikringstiltak i stor grad konsentrerer seg om å evaluere og styre modeller, mens de langt på vei overser risikoer som oppstår når KI samhandler med mennesker og institusjoner. Hovedpoenget er at sikkerhet må håndteres på nivået til systemet av mennesker og KI. Denne innrammingen plasserer samfunnsforskere, organisasjonsforskere og atferdsforskere midt i sentrum av forskningen på KI-sikkerhet.
Merkevaresynlighet i KI-søkets tidsalder
Denne artikkelen i MIT Sloan Management Review argumenterer for at søk drevet av store språkmodeller skaper to ulike utfordringer for merkevarer: å være synlige i KI-svar, og å bli fremstilt korrekt. Etter hvert som nullklikk-svar erstatter lenker på resultatsidene, flettes søkemotoroptimalisering (SEO) sammen med generativ motoroptimalisering (GEO), og nye måltall erstatter tradisjonell trafikkanalyse. For markedsføringsforskere peker dette på et måleproblem i rask utvikling med få etablerte konstrukter så langt.
Det var alt for denne uken. Videresend gjerne til en kollega som leter etter et oversett forskningsspørsmål, og utforsk KI-verktøy for din egen forskning på gaiforresearch.com.


Kommentarer