
科研中的人工智能:藏在眼皮底下的答案

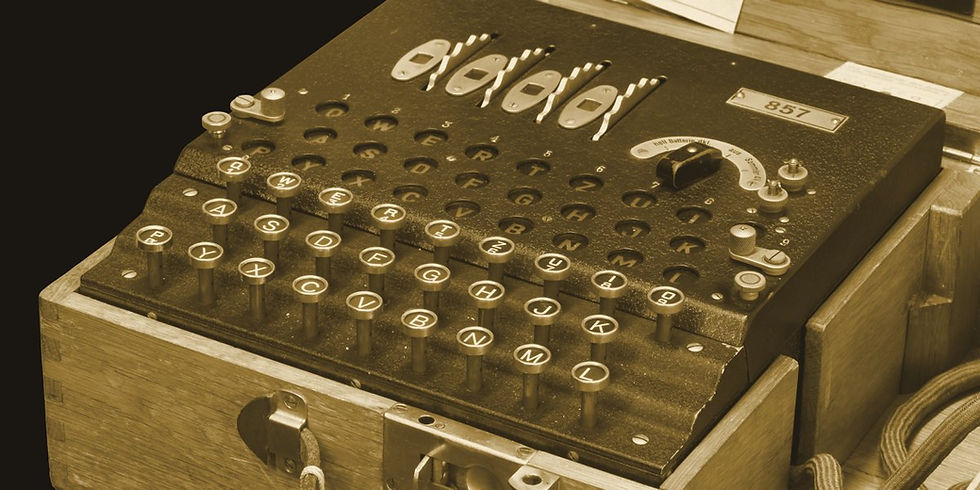
Image: "Enigma-IMG 0487-black" by Rama (CC BY-SA 2.0 fr) via Wikimedia Commons, recoloured.
欢迎阅读本周的人工智能重塑科研动态速览,内容精选自 Nature、Science、PNAS 以及顶级商业期刊。
人工智能正在找出藏在眼皮底下的答案,谁来核验?
本周有两则报道从不同的两端描述了同一种转变。Science 报道了 BootLoops,这款软件让研究者能够在 22 个学科中迅速发现并攻克问题。该工具包源自哈佛大学物理学家 Matthew Schwartz 在 Anthropic 担任访问研究员期间的工作,当时 Claude 针对一个又一个问题逐一构建工具。据有关该项目的报道,大约 400 个候选问题在三个月内被筛选为 36 篇稿件,合作作者 19 人,题目从美国联邦医疗保险(Medicare)星级评分到太阳黑子不一而足,其做法往往是把某一领域的已知方法移植到另一个从未有人想到要应用它的领域。与此同时,Nature 报道称,非专业人士正在利用大语言模型破解历史密码:其中一位毫无密码学背景的人,让模型挑选了一条 1941 年至今未破解的 Enigma 密电,编写了一个 Enigma 模拟器,并在一夜之间测试了超过四十亿种设置,直至得出解答。
两个案例的隐患如出一辙。Schwartz 发现,在不熟悉的领域中,很难判断模型何时夸大了研究发现,因此由领域专家来决定哪些结果值得深入;许多早期结果在技术上正确,但在科学上平淡无奇。密码学家也告诉 Nature,他们的收件箱里塞满了请求验证人工智能所得解答的邮件,其中许多是不懂密码分析的人提交的假阳性结果。Haiyang Zhang、Robert Wuebker 和 Jay Barney 在 Strategic Entrepreneurship Journal 上发表的一篇概念性论文为此提供了战略视角:当生成式人工智能让隐藏的租金对所有人都清晰可见时,建立在竞争性忽视之上的机会可能会失去价值;而在真正的奈特不确定性下创造出来的机会,则是生成式人工智能无法完全化解的。
为何重要: 对研究者而言,"无人注意到的唾手可得之果"正在成为一种日益缩水的资产;人工智能非常擅长把现有方法迁移到被忽视的角落。仍然稀缺的是判断力:知道哪个结果重要,并且有能力对其加以验证。如果你使用人工智能来发掘研究问题,请预先为专家验证留出预算,报告候选问题是如何筛选的(从 400 个到 36 个,这本身就是一项发现),并预期审稿人和编辑将面临与密码学家已经遭遇的同样的验证洪流。
本周更多内容
人工智能制作的广告,不像人工智能做的时候效果最好
作者在 Taboola 推出其生成式人工智能广告制作工具(GenAI Ad Maker)之前与其合作,比较了 4,633 组"同胞广告":由同一广告主在相同投放设置下、同一时间发布的人工智能生成图像与人工制作图像,覆盖超过 3.69 亿次展示和 250 万次点击。他们发现,人工智能图像在点击率上平均而言并无可检测到的劣势,但当人工智能图像"看起来不像人工智能做的"时,其表现优于人工制作的图像。耐人寻味的是,人工智能倾向于生成的特征(更锐利、更清晰、人脸更大的图像)被消费者解读为人工制作,而浓重的美学修饰、较低的温暖感和强烈的色彩饱和度则透露出人工智能的痕迹。
在序贯诊断中接受检验的人工智能"医师专家组"
这篇 Science 论文构建了一个交互式基准:诊断者从一段简短的病情陈述出发,必须选择获取哪些信息、开展哪些检查,从而可以同时衡量准确率与检查成本。一个模拟医师专家组的人工智能系统会持续修订其鉴别诊断并选择具有成本效益的检查,它在 New England Journal of Medicine 临床病理病例上的准确率达到 83.2%,在 MIMIC-IV 急诊入院病例上达到 80.3%,而全科医生分别为 36.1% 和 46.8%。作者强调这些是受控基准下的结果,但这一设计本身(对过程而不仅仅是答案进行评分)为评估人工智能在任何序贯决策任务中的表现提供了有用的模板。
人工智能如何逐项任务地重塑风险投资
这篇概念性论文提出了一种基于机制的解释,说明数据和人工智能如何重塑风险投资这一建立在地理与社会邻近性之上的行业。论文就以下方面提出了命题:项目来源(人工智能可以把漏斗拓宽到本地网络和熟人引荐之外)、项目筛选(尽职调查更快、更一致,但基于以往交易训练的模型可能偏好与既往投资相似的企业,从而错过新颖的企业),以及投后工作,在这一环节数据可以部分替代监督,但增值支持仍然高度依赖人际关系。这为创业与金融领域的学者提供了一组现成的可检验假设。
更可靠地从内部引导大语言模型
激活引导(直接操纵模型的内部激活,使其输出朝某一概念偏移)以脆弱著称。作者提出了一种注意力引导的框架,能够自动选择相关词元、处理异质的概念特征,并识别最关键的层。在一个包含 512 个语义概念的基准上,该方法成功引导的概念数量几乎是此前最先进方法的两倍,适用于最高达 700 亿参数的多种架构。对于把大语言模型当作研究工具的研究者而言,这提醒我们:模型行为可以从内部被改变,而不仅仅是通过提示词。
人工智能安全辩论遗漏了半个系统
这篇 Science 评论回应了人工智能企业高管近期向联合国安理会发出的警告,认为现有的保障提案主要集中于评估和治理模型,却在很大程度上忽视了人工智能与人和机构互动时产生的风险。其核心论点是,安全问题必须在人机系统的层面上加以应对。这一框架把社会科学家、组织研究者和行为学者直接置于人工智能安全研究的中心。
人工智能搜索时代的品牌可见度
这篇 MIT Sloan Management Review 文章认为,由大语言模型驱动的搜索给品牌带来了两项截然不同的挑战:在人工智能的回答中被看见,以及被准确地呈现。随着零点击回答取代结果页上的链接,搜索引擎优化(SEO)与生成式引擎优化(GEO)交织在一起,新的指标也在取代传统的流量分析。对营销研究者而言,这指出了一个快速演变、尚缺乏成熟构念的测量问题。
本周内容就到这里。欢迎转发给正在寻找被忽视的研究问题的同事,也欢迎访问 gaiforresearch.com,探索可用于你自己研究的人工智能工具。


留言